Perché un JSON apparentemente valido fallisce al primo carattere
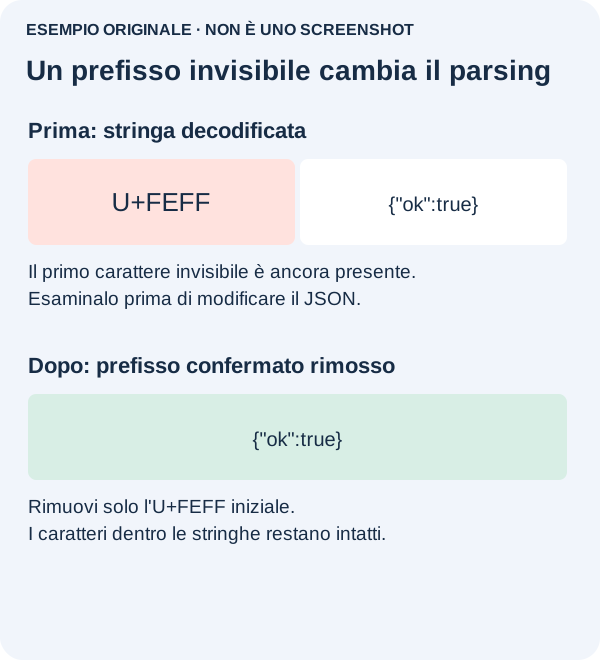
Puoi vedere un oggetto JSON valido e ricevere comunque un errore alla posizione zero. La parentesi graffa potrebbe non essere il primo carattere: un U+FEFF invisibile può precederla. Conserva l’originale prima di tentare una riparazione. Una pagina HTML di accesso, una risposta vuota o un file decodificato male richiedono soluzioni diverse.
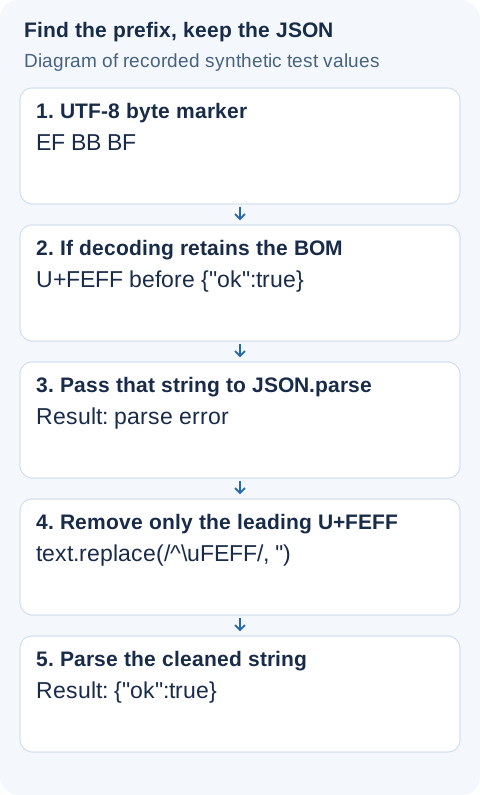
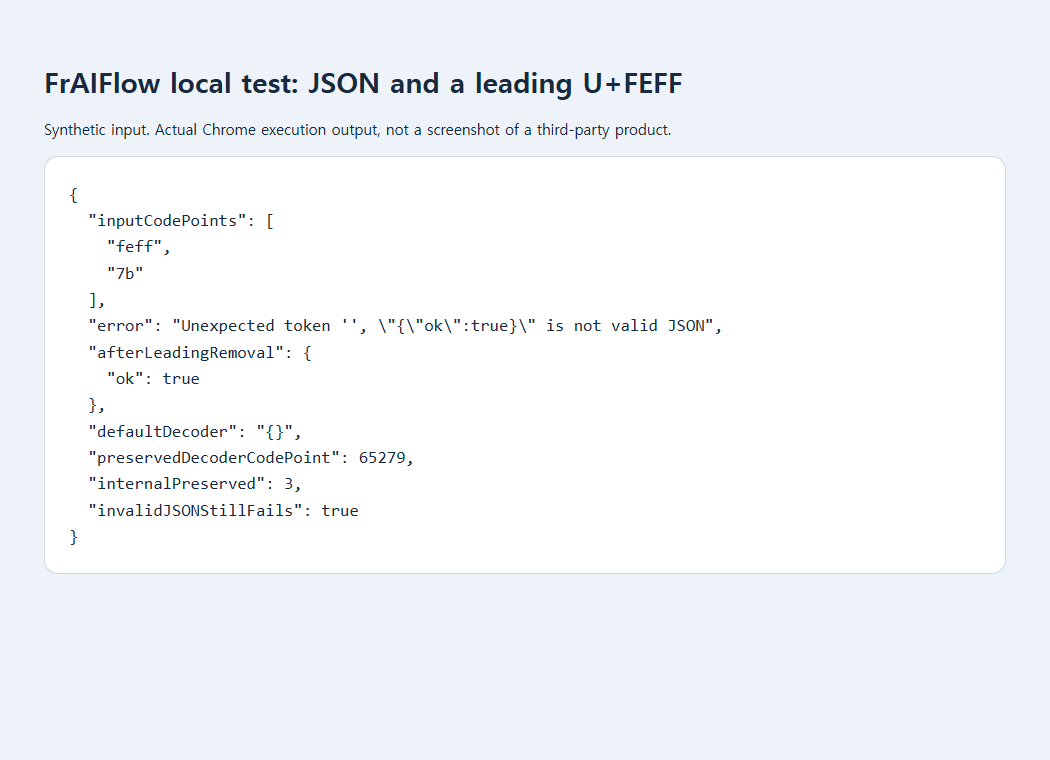
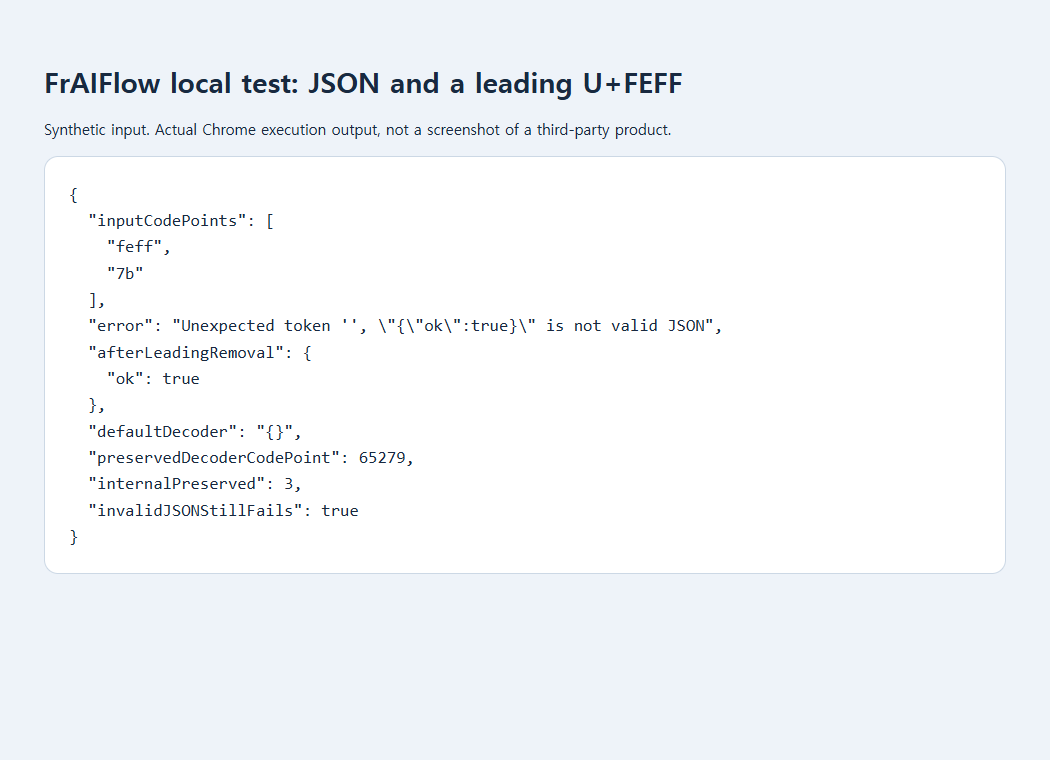
Una segnalazione Stack Overflow del 2017 ha ricondotto un errore simile di Node.js al valore decimale 65279, cioè U+FEFF. Un test locale salvato nel browser costituisce una prova separata: un U+FEFF sintetico seguito da {"ok":true} ha fallito, poi è stato interpretato dopo la rimozione del solo prefisso. La schermata documenta quel test locale, non il file del segnalante.
Una correzione prudente che puoi eseguire
Parti da una copia del file, non dal tuo unico export. Se proviene da una richiesta web, controlla prima stato HTTP e tipo di contenuto: una pagina di accesso che inizia con <!doctype html> richiede di correggere l’autenticazione, non il JSON. Per un file locale, usa un editor che mostri la codifica. Durante la diagnosi non sovrascrivere l’originale.
Dopo aver decodificato il file in una stringa JavaScript chiamata text, usa questa piccola funzione nel tuo script di importazione. Accetta un marcatore iniziale noto e lascia intatto tutto il resto.
function parseJsonText(text) {
  if (typeof text !== "string") throw new TypeError("Expected text");
  const hadBOM = text.charCodeAt(0) === 0xFEFF;
  const cleaned = hadBOM ? text.slice(1) : text;
  return { value: JSON.parse(cleaned), removedLeadingBOM: hadBOM };
}
const sample = '\uFEFF{"ok":true,"name":"한글"}';
const result = parseJsonText(sample);
console.log(result.removedLeadingBOM); // true
console.log(result.value.ok);          // true
console.log(result.value.name);        // 한글
Verificare il successo non significa soltanto che “l’errore è sparito”. Controlla le proprietà attese e la leggibilità del testo non inglese. Prova la funzione anche su JSON ordinario: deve interpretarlo senza segnalare un marcatore rimosso. Un input vuoto o un oggetto malformato deve ancora generare un’eccezione. Lascia che l’errore raggiunga il chiamante invece di restituire un oggetto vuoto scambiabile per dati validi.
Se il primo punto di codice non è U+FEFF, non usare questa correzione. Un file decodificato con la codifica sbagliata può contenere caratteri sostitutivi o caratteri nulli alternati. Riaprilo con la codifica scelta dall’esportatore oppure richiedi un nuovo export UTF-8. Eliminare caratteri non ricostruisce byte decodificati male.
La differenza fra byte e carattere invisibile
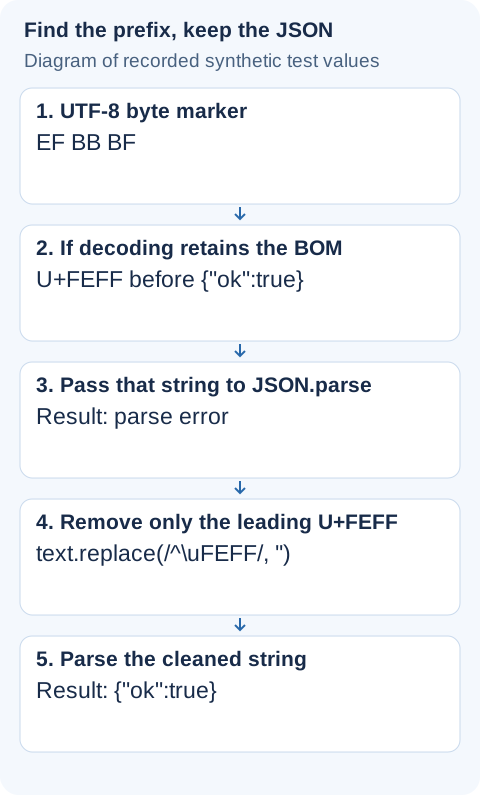
TextDecoder("utf-8") normalmente omette un BOM UTF-8 iniziale. L’opzione ignoreBOM è controintuitiva: true include il marcatore nella stringa decodificata. Il nostro campione EF BB BF 7B 7D è diventato {} con il comportamento predefinito. Non si tratta di riconoscimento automatico della codifica.
Controlla chi produce il file
Un’altra segnalazione su PowerShell riguardava un percorso di decodifica sbagliato. Out-File e la redirezione di Windows PowerShell possono produrre UTF-16LE; il comportamento delle versioni più recenti cambia. Eliminare il testo non ASCII può distruggere nomi validi senza risolvere l’incompatibilità. Verifica comando e versione del produttore, poi decodifica o riesporta correttamente. Quel flusso di lavoro non è stato riprodotto nel nostro test.
RFC 8259 richiede UTF-8 per JSON scambiato fuori da un ecosistema chiuso e vieta ai produttori di aggiungere un BOM nelle trasmissioni di rete. Se possibile, correggi l’esportatore. Nel punto di importazione, prova JSON ordinario, il prefisso confermato, JSON malformato e valori non inglesi. Registra solo il prefisso diagnostico, non contenuti privati del documento.
Fonti, esempi e approfondimenti
- Discussione pubblica: JSON.parse genera SyntaxError alla posizione 0
- Schema di supporto originale
- Documentazione del test locale salvato
- Riferimento MDN: ignoreBOM
- Discussione pubblica: token inatteso in JSON alla posizione 0
- Documentazione Microsoft: about_character_encoding
- RFC 8259: formato di interscambio dati JSON
- Perché testi apparentemente identici non corrispondono
- Perché Base64 non funziona con il testo non inglese