Pourquoi un JSON apparemment valide échoue dès le premier caractère
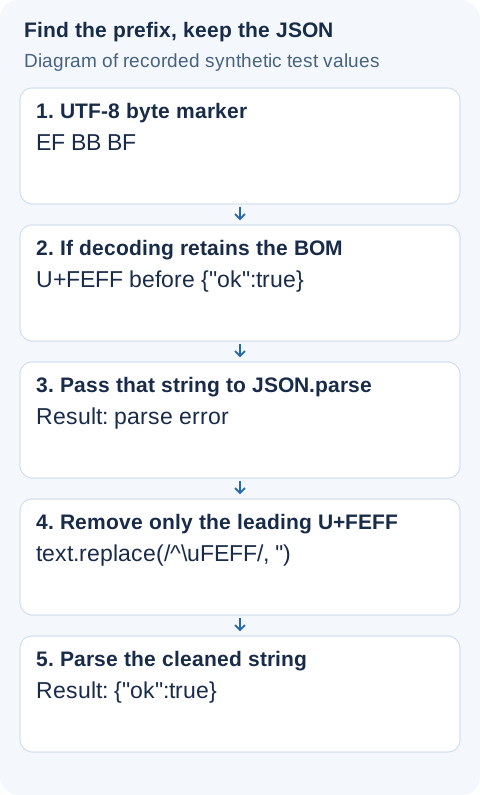
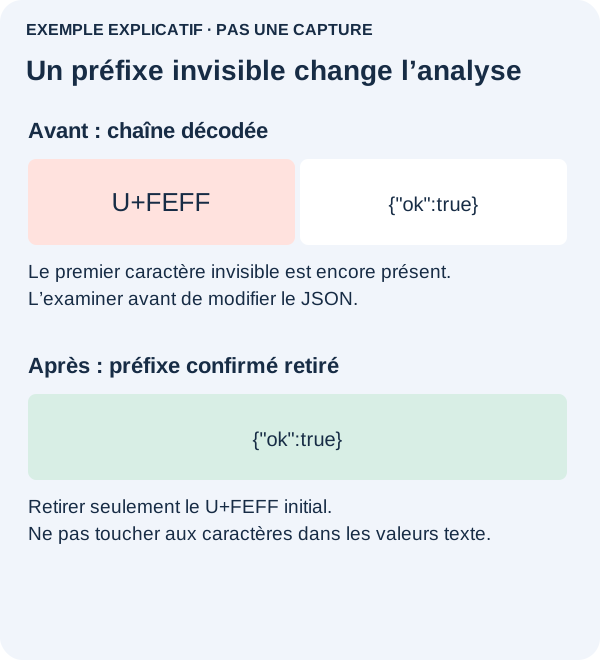
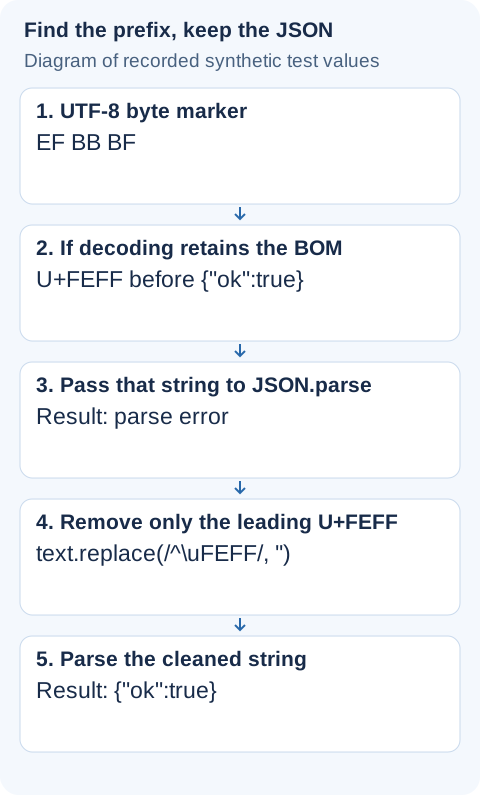
Votre objet JSON semble correct, mais l’analyse échoue à la position zéro. L’accolade ouvrante n’est peut-être pas le premier caractère : un U+FEFF invisible peut la précéder. Conservez l’original avant toute réparation. Une page de connexion HTML, une réponse vide ou un fichier mal décodé nécessitent une autre solution.
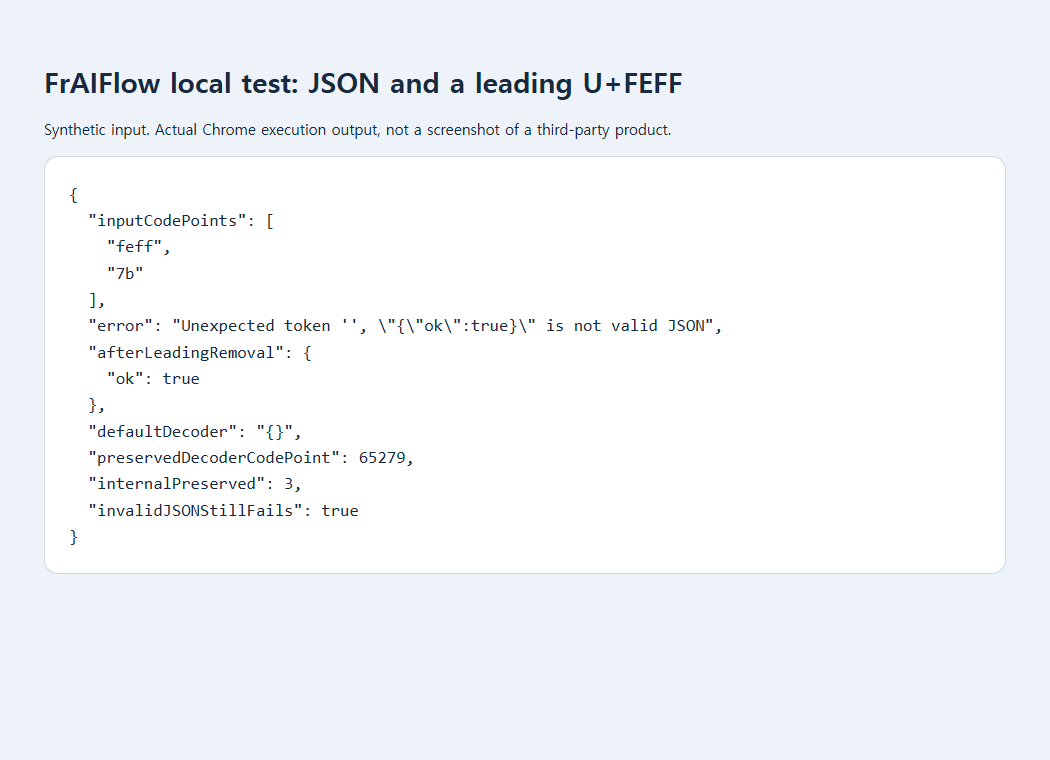
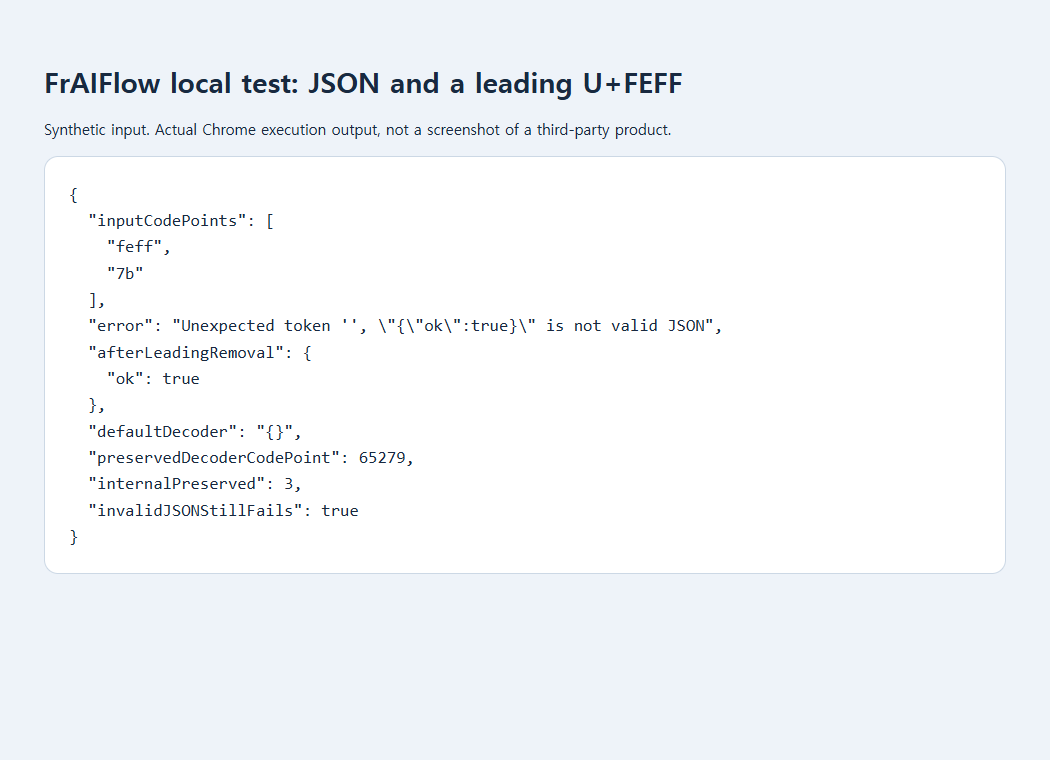
Dans un signalement publié sur Stack Overflow en 2017, une erreur similaire sous Node.js a été attribuée à la valeur décimale 65279, soit U+FEFF. Un test local enregistré dans un navigateur constitue une preuve distincte : une chaîne synthétique composée de U+FEFF suivi de {"ok":true} a échoué, puis a été analysée après suppression du seul préfixe. La capture montre ce test local, pas le fichier de l’auteur du signalement.
Une correction prudente que vous pouvez exécuter
Commencez par une copie du fichier, pas par votre unique export. Si les données viennent d’une requête web, vérifiez d’abord son statut HTTP et son type de contenu : une page de connexion qui commence par <!doctype html> exige de corriger l’authentification, pas de nettoyer le JSON. Pour un fichier local, utilisez un éditeur capable d’afficher son encodage. N’écrasez pas l’original pendant le diagnostic.
Une fois le fichier décodé dans une chaîne JavaScript nommée text, utilisez la petite fonction suivante dans votre script d’import. Elle accepte un marqueur initial connu et laisse tout le reste intact.
function parseJsonText(text) {
  if (typeof text !== "string") throw new TypeError("Expected text");
  const hadBOM = text.charCodeAt(0) === 0xFEFF;
  const cleaned = hadBOM ? text.slice(1) : text;
  return { value: JSON.parse(cleaned), removedLeadingBOM: hadBOM };
}
const sample = '\uFEFF{"ok":true,"name":"한글"}';
const result = parseJsonText(sample);
console.log(result.removedLeadingBOM); // true
console.log(result.value.ok);          // true
console.log(result.value.name);        // 한글
Vérifier la réussite ne consiste pas seulement à constater que l’erreur a disparu. Assurez-vous que les propriétés attendues existent et que le texte non anglais reste lisible. Essayez aussi la fonction sur du JSON ordinaire : elle doit l’analyser sans signaler de marqueur supprimé. Une entrée vide ou un objet mal formé doit toujours lever une exception. Laissez cette erreur parvenir à l’appelant au lieu de renvoyer un objet vide, qui risquerait d’être pris pour une donnée valide.
Si le premier point de code n’est pas U+FEFF, n’utilisez pas cette correction. Un fichier décodé avec le mauvais encodage peut, par exemple, contenir des caractères de remplacement ou des caractères nuls alternés. Rouvrez-le avec l’encodage choisi par le logiciel d’export, ou demandez un nouvel export UTF-8. Supprimer des caractères ne permet pas de reconstruire des octets mal décodés.
Distinguer les octets du caractère invisible
TextDecoder("utf-8") omet normalement un BOM UTF-8 initial. Son option ignoreBOM est contre-intuitive : true conserve le marqueur dans la chaîne décodée. Notre jeu d’octets de test EF BB BF 7B 7D est devenu {} avec le comportement par défaut. Ce mécanisme n’est pas une détection automatique de l’encodage.
Vérifiez le programme qui produit les données
Un autre signalement concernant PowerShell portait sur une mauvaise méthode de décodage. Sous Windows PowerShell, Out-File et la redirection peuvent produire du UTF-16LE ; le comportement des versions plus récentes de PowerShell diffère. Supprimer le texte non ASCII peut détruire des noms valides sans résoudre cette incompatibilité. Vérifiez la commande et la version utilisées, puis décodez correctement ou refaites l’export. Le parcours de cet utilisateur n’a pas été reproduit dans notre test.
La RFC 8259 impose l’UTF-8 pour le JSON échangé hors d’un écosystème fermé et interdit aux producteurs d’ajouter un BOM aux données transmises sur le réseau. Corrigez l’exporteur si possible. À l’entrée de l’import, testez du JSON ordinaire, le préfixe confirmé, du JSON mal formé et des valeurs non anglaises. Ne journalisez que le préfixe utile au diagnostic, jamais le contenu privé des documents.
Sources, exemples et lectures complémentaires
- Discussion publique : erreur SyntaxError de JSON.parse à la position 0
- Schéma explicatif d’origine
- Preuve conservée du test local
- Référence MDN : ignoreBOM
- Discussion publique : jeton inattendu lors de l’analyse JSON à la position 0
- Documentation Microsoft : about_character_encoding
- RFC 8259 : format d’échange de données JSON
- Pourquoi deux textes visuellement identiques ne correspondent pas
- Pourquoi Base64 pose problème avec les textes non anglais