Vì sao văn bản trông giống nhau lại không khớp?
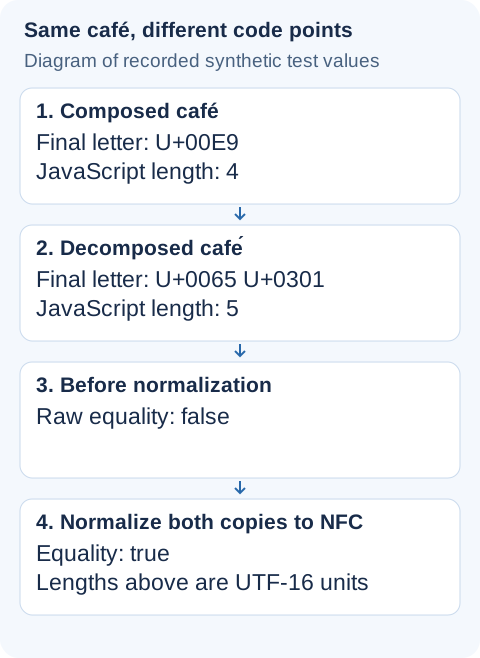
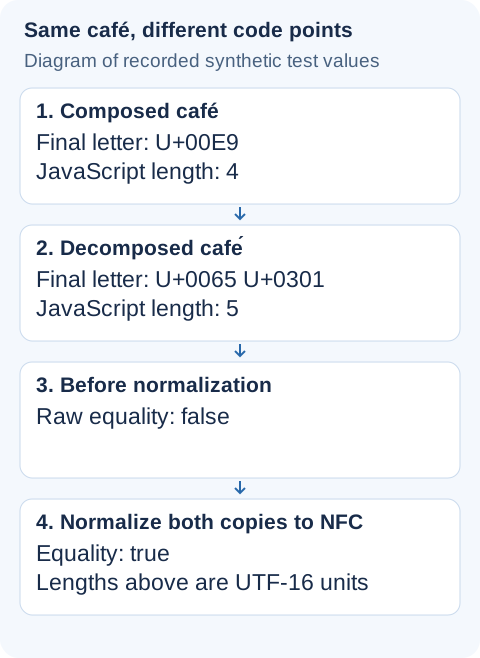
Hai bản café có thể trông giống hệt mà phép so sánh vẫn trả về khác nhau. Một bản kết thúc bằng U+00E9; bản kia bằng U+0065 theo sau bởi dấu kết hợp U+0301. Dấu trên chữ không bị sai. Hai chuỗi chỉ lưu chữ đó bằng các điểm mã Unicode khác nhau, và phép so sánh cần tính đến sự khác biệt này.
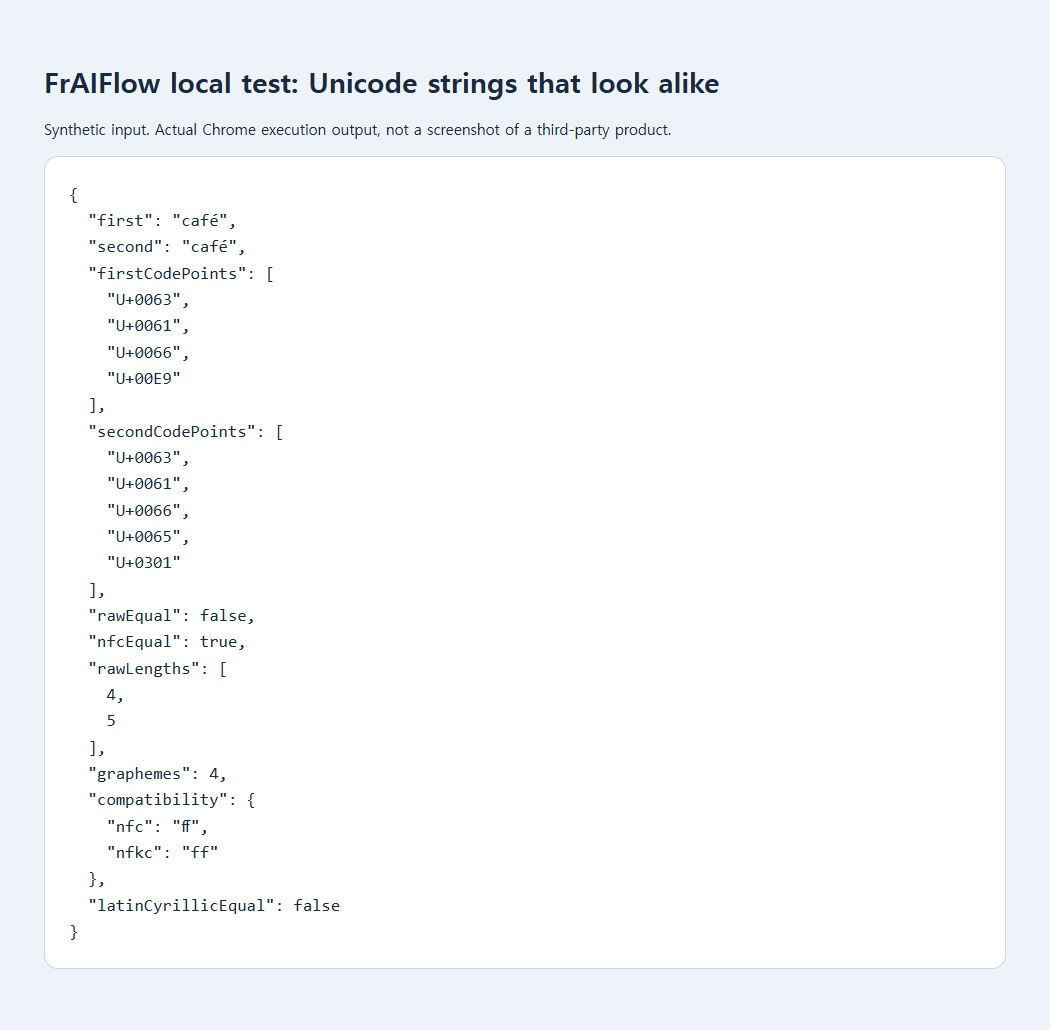
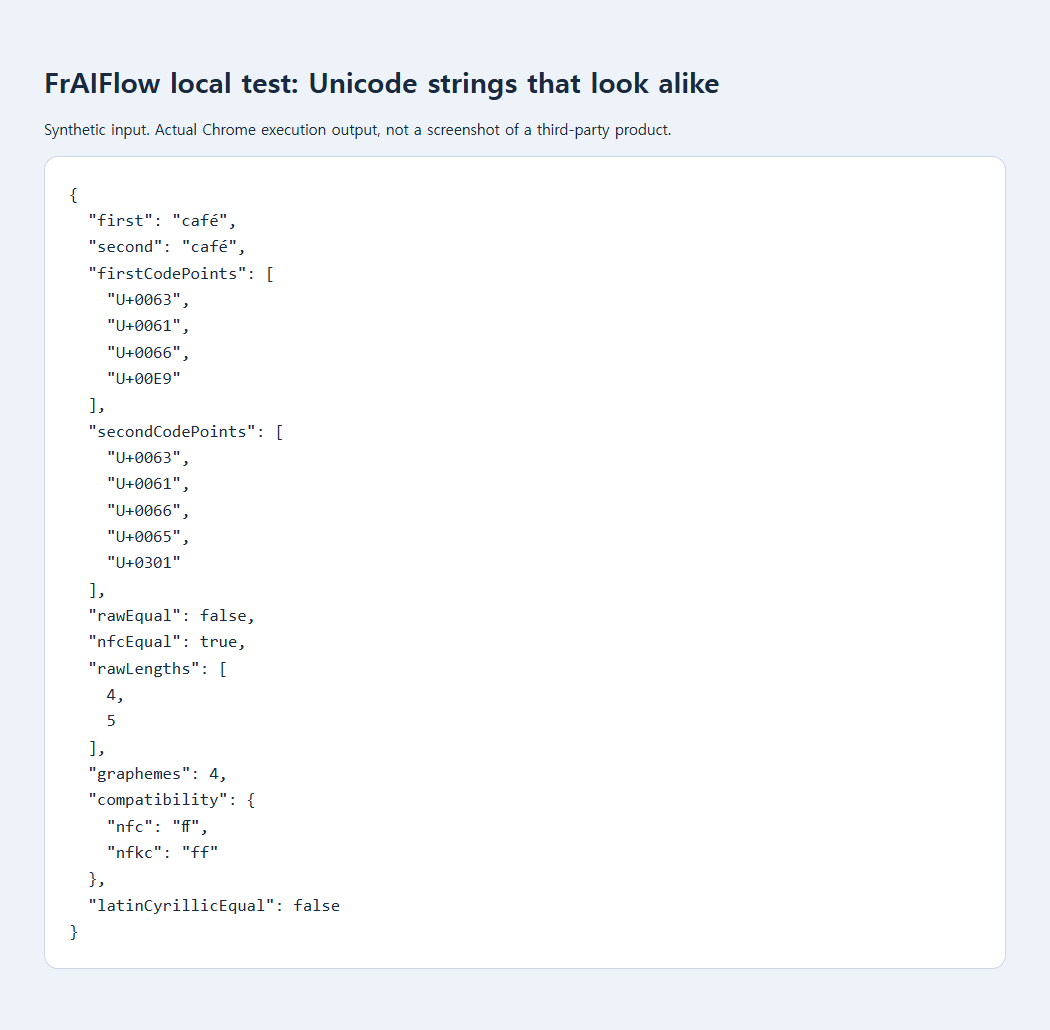
Câu hỏi Stack Overflow năm 2019 mô tả văn bản tiếng Việt nhìn tương tự nhưng không vượt qua kiểm tra bằng nhau. Câu trả lời dùng cùng một dạng chuẩn hóa. Thử nghiệm trình duyệt đã lưu của chúng tôi dùng cặp café tổng hợp khác: so sánh trực tiếp là false, còn so sánh hai dạng NFC là true. Nó không tái hiện ứng dụng của người hỏi.
Trước tiên xử lý một cặp không khớp
Trước khi thay đổi cả bảng tính hoặc cơ sở dữ liệu, sao chép riêng hai giá trị đáng lẽ khớp vào script cục bộ nhỏ. Dùng mẫu vô hại nếu giá trị thật nhận diện khách hàng. Xem điểm mã cạnh nhau hữu ích hơn việc gõ lại dấu nhiều lần.
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
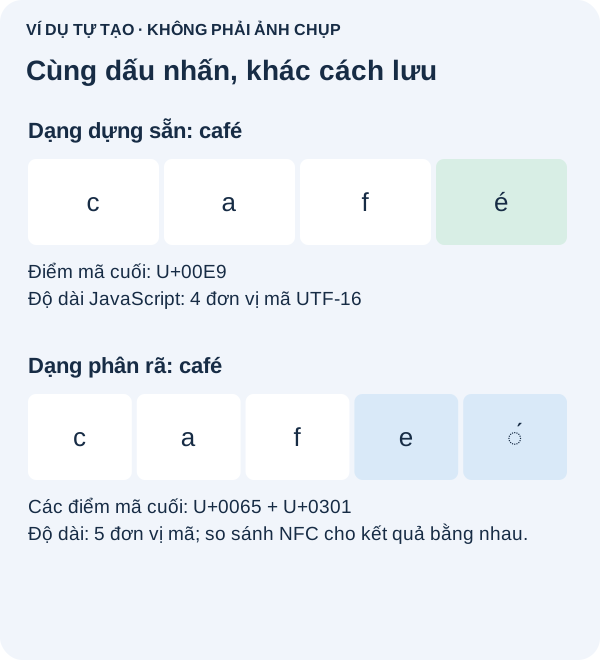
Đọc hai chuỗi từ trái sang phải. Ở đây ba chữ đầu giống nhau; chỉ biểu diễn của chữ có dấu cuối khác. Đó chính là tình huống NFC xử lý. Hình bên dưới làm rõ hai cách lưu; dấu thêm là dấu kết hợp, không phải chữ thừa ngoài ý muốn.
Với so sánh tìm kiếm hoặc nhập dữ liệu, tạo khóa chuẩn hóa riêng và giữ giá trị gốc để hiển thị. Chuẩn hóa cả hai phía, gồm giá trị đã nằm trong cơ sở dữ liệu. Chỉ chuẩn hóa đầu vào mới sẽ để bản ghi cũ không nhất quán. Trước khi áp dụng cho tất cả, thử vài cặp cần khớp và vài cặp phải khác.
Nếu kết quả vẫn false, kiểm tra khoảng trắng cuối, khoảng trắng không ngắt hoặc chữ thuộc bảng chữ khác. Đừng phản ứng bằng cách bỏ mọi dấu và dấu câu. Đó là chính sách khớp bổ sung có thể gộp các tên khác nhau. Nếu nhóm trùng đề xuất ảnh hưởng tài khoản, thanh toán hay danh tính, hãy đưa ra để xem xét thay vì coi giống hình thức là bằng chứng.
Tách so sánh khỏi xác định danh tính
Khớp theo NFC không chứng minh hai tài khoản thuộc một người. Xem trước nhóm trùng đề xuất và quyết định khớp có ý nghĩa gì với dữ liệu. Đừng thêm chuẩn hóa vào mật khẩu, chữ ký hoặc token không được diễn giải như một bước dọn dẹp tiện tay: các hệ thống đó có thể đòi hỏi byte hoặc ký tự chính xác.
Vì sao không dùng NFKC ở mọi nơi?
NFKC bổ sung ánh xạ tương thích. Trong thử nghiệm đã ghi, chữ ghép U+FB00 không đổi dưới NFC nhưng thành ff dưới NFKC. Điều đó có thể hữu ích cho khóa tìm kiếm chủ ý linh hoạt, nhưng làm mất khác biệt cần giữ trong văn bản gốc. Chọn chính sách trước rồi mới chọn phép biến đổi.
Chuẩn hóa cũng không giải quyết ký tự giống hình: a Latin và U+0430 Cyrillic vẫn không bằng nhau trong ví dụ. Nó cũng không định nghĩa giới hạn ký tự của website. Hai dạng café đo được 4 và 5 đơn vị mã UTF-16 JavaScript; phân đoạn tự vị của từ dạng tách cho 4 nhóm theo cách người đọc nhìn. Đây là các phép đo khác nhau.
Nguồn, ví dụ và bài đọc thêm
- Thảo luận công khai: cùng văn bản nhưng không bằng nhau, làm sao chuyển về cùng cách mã hóa
- Sơ đồ bổ trợ gốc
- Bằng chứng thử nghiệm cục bộ đã lưu
- Tài liệu MDN: normalize
- Đặc tả chuẩn hóa Unicode
- Tài liệu MDN: length
- Thảo luận công khai: đếm đúng độ dài chuỗi có emoji trong JavaScript
- Vì sao JSON trông hợp lệ lại lỗi ngay ký tự đầu?
- Vì sao Base64 làm hỏng văn bản không phải tiếng Anh?