Por qué dos textos visualmente idénticos no coinciden
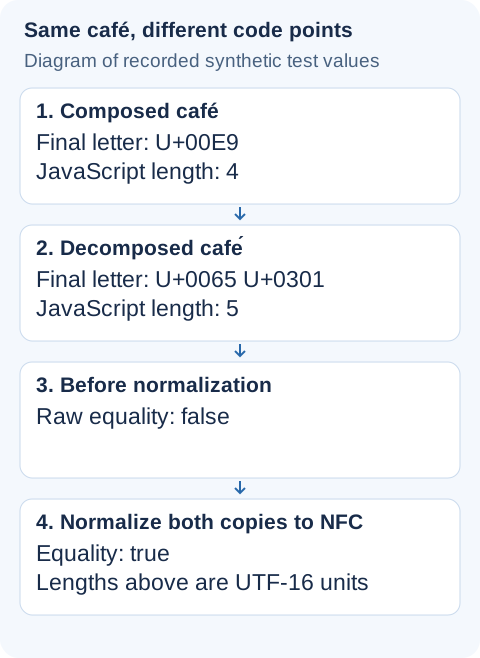
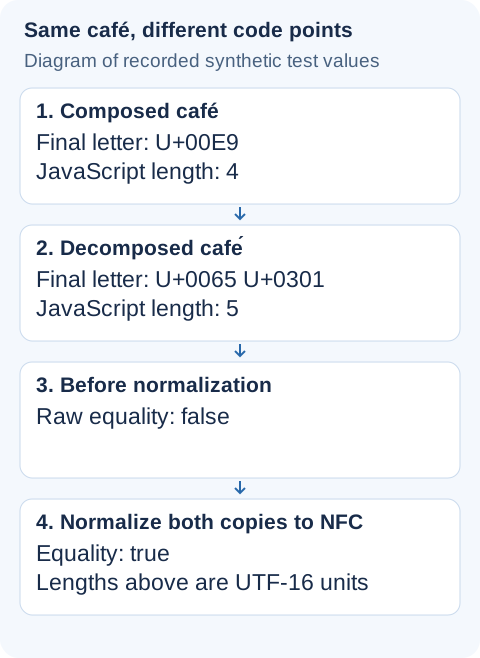
Dos versiones de café pueden parecer idénticas y, aun así, resultar distintas al compararlas. Una puede terminar en U+00E9; la otra, en U+0065 seguido del carácter combinante U+0301. El acento no está mal. Las secuencias Unicode almacenadas son diferentes y la regla de comparación debe tener en cuenta esa diferencia.
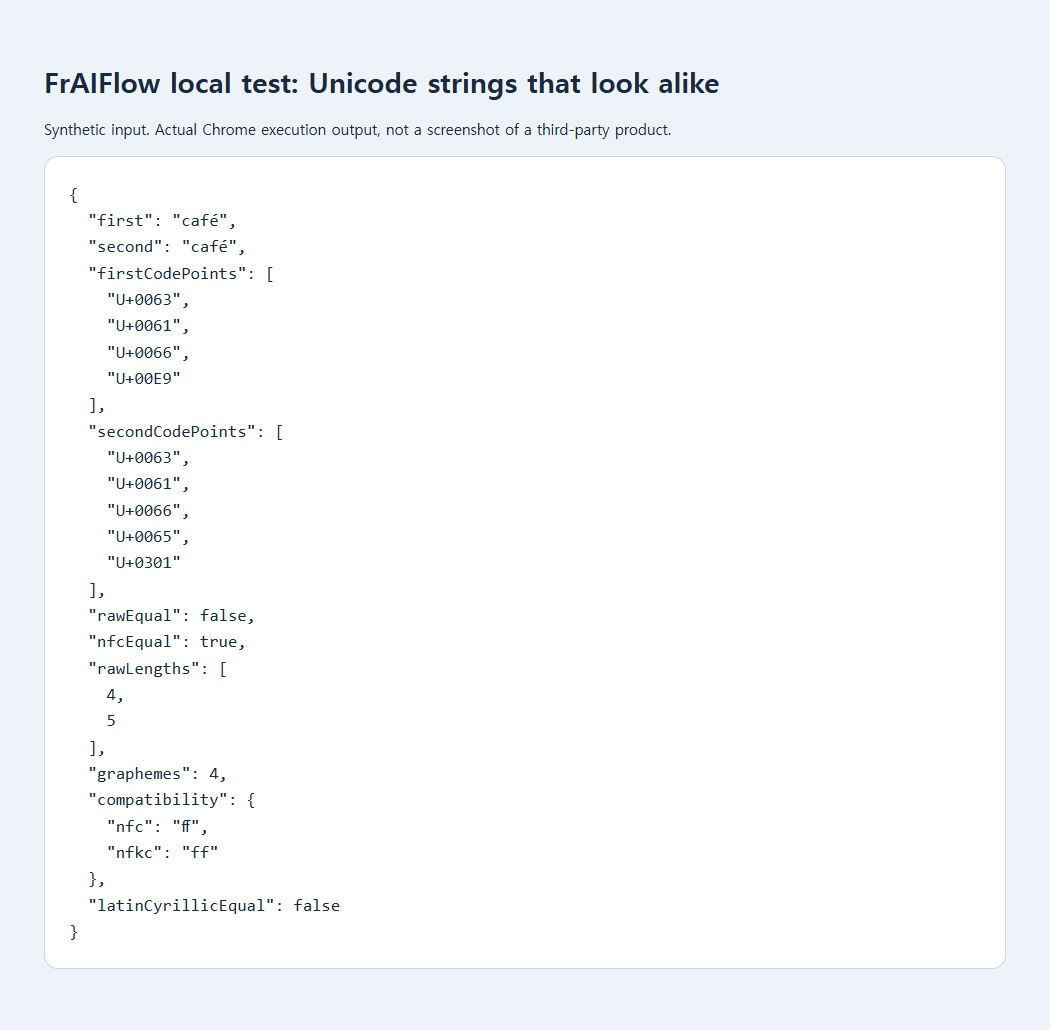
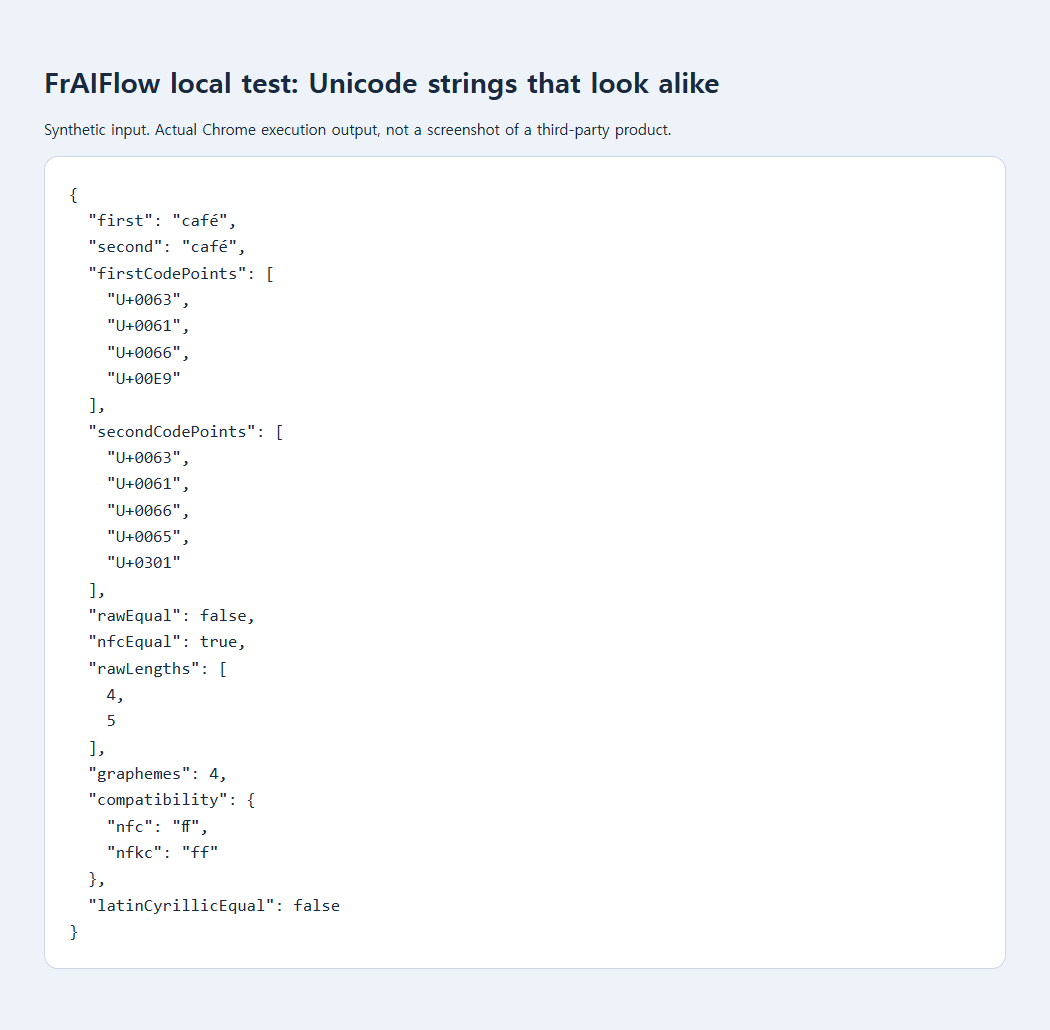
Una pregunta de Stack Overflow de 2019 describía textos vietnamitas visualmente similares que no superaban una comparación de igualdad. La respuesta utilizaba una forma de normalización común. Nuestra prueba de navegador guardada usa otro ejemplo sintético, con dos versiones de café: la igualdad directa dio false, mientras que comparar sus formas NFC dio true. No es una reproducción de la aplicación de aquella consulta.
Empiece por una sola pareja que no coincida
Antes de modificar toda una hoja de cálculo o base de datos, copie únicamente los dos valores que deberían coincidir en un pequeño script local. Si los valores reales identifican a clientes, sustitúyalos por ejemplos inocuos. Ver los puntos de código uno junto al otro ayuda mucho más que volver a escribir el acento una y otra vez.
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
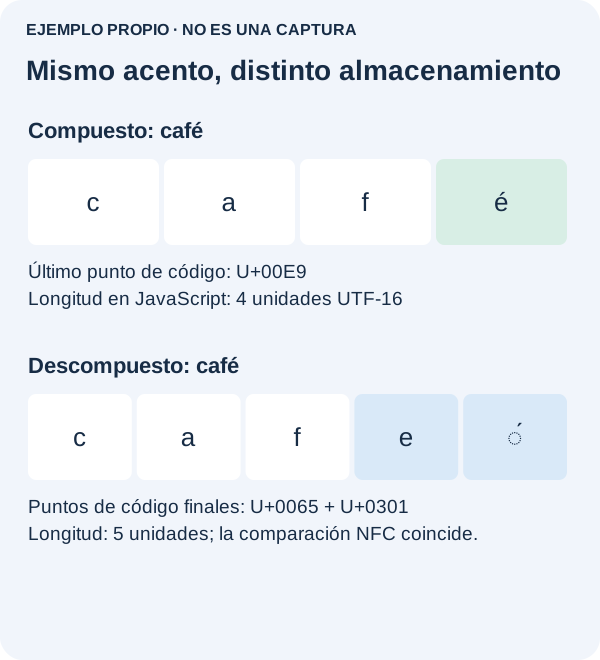
Lea ambas secuencias de izquierda a derecha. Aquí coinciden las tres primeras letras; solo cambia la representación de la última letra acentuada. Esa es precisamente la situación que resuelve NFC. La ilustración muestra las dos formas de almacenamiento: la marca adicional es un acento combinante, no una letra sobrante.
Para comparar durante una búsqueda o importación, cree una clave normalizada independiente y conserve el valor original para mostrarlo. Normalice ambos lados de la comparación, incluidos los valores que ya están en la base de datos. Normalizar únicamente las entradas nuevas deja registros antiguos con criterios distintos. Antes de aplicar la regla a todos los registros, pruebe varias parejas que deban coincidir y otras que deban seguir siendo diferentes.
Si el resultado sigue siendo false, busque un espacio final, un espacio de no separación o una letra de otro alfabeto. No elimine automáticamente todos los acentos ni los signos de puntuación. Esas son reglas adicionales que pueden confundir nombres diferentes. Si un posible duplicado afecta a cuentas, pagos o identidades, sométalo a revisión en lugar de tomar el parecido visual como prueba.
Separe la comparación de la identidad
Una coincidencia tras aplicar NFC no demuestra que dos cuentas pertenezcan a la misma persona. Revise los grupos de posibles duplicados y decida qué significa una coincidencia para esos datos. No añada normalización a contraseñas, firmas ni tokens opacos como simple limpieza: esos sistemas pueden exigir una secuencia exacta de bytes o caracteres.
¿Por qué no usar NFKC en todos los casos?
NFKC añade conversiones de compatibilidad. En la prueba registrada, la ligadura U+FB00 no cambió con NFC, pero se convirtió en ff con NFKC. Esto puede ser útil para una clave de búsqueda deliberadamente flexible, aunque también elimina una distinción que quizá sea importante conservar en el texto original. Elija primero la regla y después la transformación.
La normalización tampoco resuelve los caracteres parecidos: la a latina y U+0430 del alfabeto cirílico siguieron siendo distintas en el ejemplo. Ni determina cómo debe contar caracteres un sitio web. Las dos versiones de café ocuparon 4 y 5 unidades de código UTF-16 en JavaScript; al segmentar la palabra descompuesta en grafemas se obtuvieron 4 grupos percibidos por el lector. Son mediciones distintas.
Fuentes, ejemplos y lecturas relacionadas
- Consulta pública: textos iguales a la vista que no son iguales al compararlos
- Diagrama explicativo original
- Evidencia guardada de la prueba local
- Referencia de MDN: normalize
- Especificación de normalización Unicode
- Referencia de MDN: length
- Consulta pública: cómo contar correctamente la longitud de una cadena con emojis en JavaScript
- Por qué un JSON aparentemente válido falla en el primer carácter
- Por qué Base64 falla con texto no inglés